发生了什么
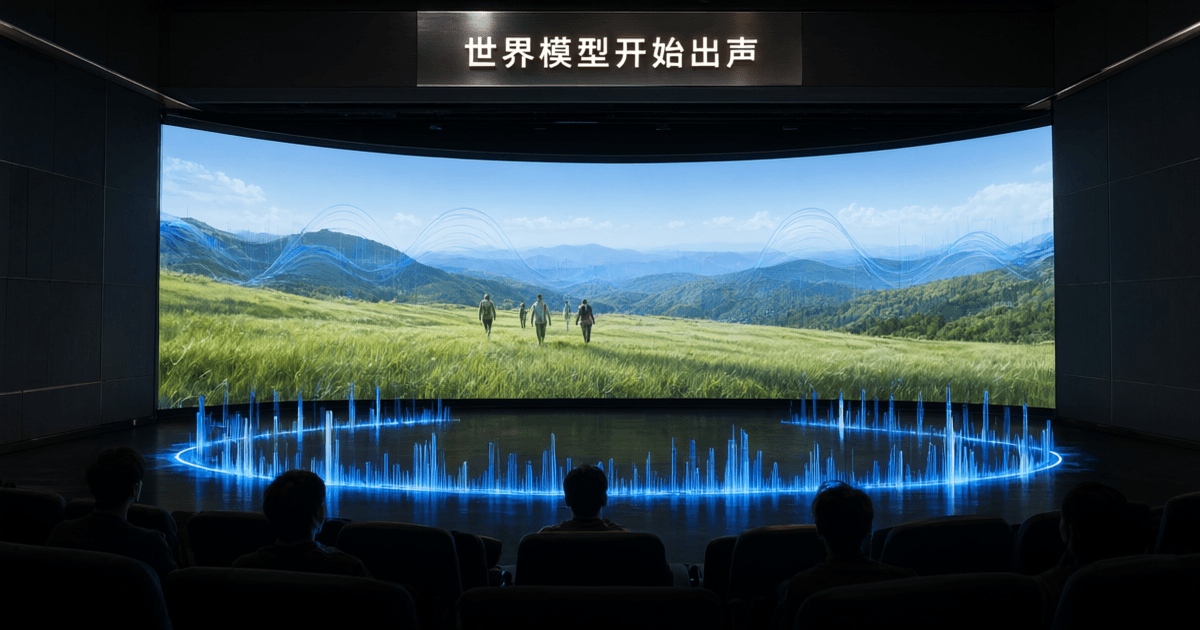
10 月 27 日,谷歌 DeepMind 发布 Genie 4,定位是「新一代世界模拟」。与前代最大的差别在于它原生多模态:画面、环境声、音乐与角色对话在同一时刻生成,而不是先出画面再配音。官方给出的四条能力线是更逼真的静态质感、实时自然语言操控、原生音频,以及与 Gemini 家族的深度耦合。
- 实时操控:用户可以按键盘在场景中行走与转视角,同时用文字改变天气、移动镜头、加入新人物或物体;Gemini 会把提示改写成与当前场景匹配的表述,并在两次输入之间持续观察、维持世界连贯推进。
- 原生音频:环境音按场景自动匹配,官方举例是树间风声与拍岸浪声;角色之间可以对话并对场景中发生的事件作出反应。
- 物理与人物:官方称模型具备空气动力、碰撞等物理场景的模拟能力,并称本轮最大的跨越是人物——动作更自然、表情与语音更接近真人。
- 架构:Gemini Omni 负责把模拟锚定在真实世界的外观与行为上,Gemini 3.8 Flash 充当回路中的引导代理,观察画面、把目标拆成步骤、逐帧校验进度。
为什么重要
世界模型的价值不在「生成好看的视频」,而在能否当作可反复试错的训练场。对企业而言,最直接的落点是机器人与智能体:先在模拟中跑通再上真机,可以显著压低试错成本。官方演示里已有具身案例——Gemini 4 Argon 与 Genie 4 配合,把「和 Apptronik 的 Apollo 人形机器人下一盘跳棋」拆成实时步骤并渲染出来。
另一条线是内容工业。DeepMind 工程师在吹风会上提到,实时性最值钱的环节是构思与故事板——需要保持创作心流、快速出概念的时刻;影视预演、游戏原型、互动教学都被列为目标场景。这也解释了谷歌为何把 Genie 放在 Project Genie 订阅体系里推,而不是只做研究展示。
不确定之处
官方在博客中明确列出当前局限:模拟时间变长、多次复杂改动或大幅移动视角之后,视觉细节与物体恒存性会漂移;复杂物理交互、实时音频的准确性、画面内可读文字、空间精度与长时一致性都还在研究中。所有产出都会嵌入 SynthID 水印,覆盖视频与音频两种模态。
开放节奏是研究预览,先给受信测试者,随后才轮到 Google AI Ultra 订阅用户与 Gemini API、AI Studio 的早期合作方,候补名单已开放。至于「单段场景可维持约两分钟、为 Genie 3 两倍」这一数字,来自媒体吹风会的转述,官方博客正文未列出该指标,宜按未在文档中确认的口径看待。